Se afișează postările cu eticheta Arhitectura sistemelor de calcul. Afișați toate postările

28 martie 2014

GEM5 example | configuration | commands | with Parsec

### configuration ###
cores: 8
CPU clock: 2GHz
Memory: 1GB
L1-Cache size: 64kB
L1-Cache associativity: 2
L2-Cache size: 256kB
L2-Cache associativity: 16
Parsec Benchmark: streamcluster
Parsec Benchmark size: simdev

###

GEM5 commands (run from gem5 directory):

0) download from [here] the script generator: writescripts.pl & the input set files.

1) run this script to create other scripts, using one of the available benches:
> ./writescripts.pl streamcluster 8
The results will be:
streamcluster_8c_simdev.rcS
streamcluster_8c_simlarge.rcS
streamcluster_8c_simmedium.rcS
streamcluster_8c_simsmall.rcS
streamcluster_8c_test.rcS
2) run the command which creates the configuration & run the generated streamcluster_8c_simdev.rcS script on it:
> ./build/ALPHA/gem5.opt --stats-file=test.out ./configs/example/fs.py --kernel=/localhome/yourUser/M5_system_ALPHA_small/binaries/vmlinux_2.6.27-gcc_4.3.4 --disk-image=/localhome/yourUser/M5_system_ALPHA_small/disks/linux-parsec-2-1-m5-with-test-inputs.img --cpu-clock=2GHz -n 8 --mem-size=1GB --caches --l1d_size=32kB --l1i_size=32kB --l1d_assoc=2 --l1i_assoc=2 --l2cache --l2_size=256kB --l2_assoc=16 --script=/localhome/yourUser/gem5/streamcluster_8c_simdev.rcS
The result of this script is ready in m5out/test.out

4) if you run the configuration without any script, the configuration will be created & you can connect to this computer via telnet, have access to a console and write whatever commands you like.
> ./build/ALPHA/gem5.opt --stats-file=test.out ./configs/example/fs.py --kernel=/localhome/yourUser/M5_system_ALPHA_small/binaries/vmlinux_2.6.27-gcc_4.3.4 --disk-image=/localhome/yourUser/M5_system_ALPHA_small/disks/linux-parsec-2-1-m5-with-test-inputs.img --cpu-clock=2GHz -n 8 --mem-size=1GB --caches --l1d_size=32kB --l1i_size=32kB --l1d_assoc=2 --l1i_assoc=2 --l2cache --l2_size=256kB --l2_assoc=16
Output:
.....
Listening for system connection on port 3456
...
> telnet localhost 3456
> ls

06 mai 2011

Operatii pe vectori si matrici, folosind CPU si GPU

1. Dublarea fiecarui element al unui vector, in mod normal si prin cuda. (doubleArr.cu)
2. Adunarea a doua matrici, in mod normal si prin cuda. (matadd.cu)

Link: http://dl.dropbox.com/u/24465060/Cuda_Ex.zip
Rezultatul returnat reprezinta echivalenta valorilor calculate pe CPU fata de cele calculate in GPU.

Compilarea se face:
nvcc fisier.cu -o fisier
./fisier

29 aprilie 2011

Mini-problema labirintului

In memoria principala este definita o matrice ce descrie calea de la intrarea într-un labirint pana la o comoara. Drumul spre comoara este encodat în matrice ca un set de salturi de la niste coordonate la altele (un nod din drum contine ca informatie urmatorul nod la care trebuie sa se sara). Stim ca am ajuns la comoara cand trebuie sa sarim la nodul (0, 0). In programul din PPU se scrie drumul în labirint si trimite SPU-ului adresa catre începutul matricii. SPU-ul va trebui sa gaseasca coordonatele comorii si sa le scrie în prima celula a labirintului (0, 0). In PPU la sfarsit se va verifica daca in celula (0, 0) se gasesc coordonatele comorii.

Rezolvare: http://dl.dropbox.com/u/24465060/labXcell.zip

----

Instructiune Descriere
cache_rd(name, eaddr) Copiaza valoarea stocata la adresa eaddr in cache. Returneaza valoarea.
cache_wr(name, eaddr, val) Scrie in cache valoarea val.
cache_touch(name, eaddr) Aduce in cache valoarea stocata la adresa eaddr. Functia este non-blocanta. Functia intoarce adresa din spatiul de adrese al LS, unde va fi stocata valoarea la incheierea tranferului.
cache_wait(name, lsa) Asteapta terminarea unui transfer non-blocant, care intoarce date la adresa lsa din spatiul LS-ului.
cache_rw(name, eaddr) Copiaza in cache valoarea stocata la adresa eaddr, transmitand sistemului de cache faptul ca valoarea ar putea fi modificata. Functia este blocanta si va intoarce adresa din spatiul LS unde va fi stocata valoarea. Linia de cache este marcata dirty la scrierea datelor.
cache_lock(name, lsa) Blocheaza datele de la adresa lsa din cache.
cache_unlock(name, lsa) Deblocheaza date de la adresa lsa din cache.
cache_flush(name)
cache_rd_x4(name, eaddr4) Citeste un vector care contine 4 valori unsigned int.
e_pr_stats(name) Afiseaza statistici despre cache.
Un program care utilizeaza sofware caching trebuie sa includa fisierul header “cache-api.h” si poate contine la inceputul sau definitii pentru:
  • 'CACHE_NAME' - un nume unic ce va identifica cache-ul.
  • 'CACHED_TYPE' - tipul elementelor stocate in cadrul cache-ului. Poate fi orice tip de date valid in limbajul C.
  • 'CACHELINE_LOG2SIZE' - log2 (dimensiunea unei linii de cache).
  • 'CACHE_LOG2NWAY' - specifica asociativitatea cache-ului. Exista 2 valori posibile: 0 si 2 (2 fiind valoarea implicita).
  • 'CACHE_LOG2NSETS' - log2 (numarul de seturi dintr-un cache). Valorile posibile sunt cuprinse intre 0 si 12. Valoarea implicita este 6 (26 = 64 seturi).
  • 'CACHE_TYPE' - tipul de acces la cache: read-only (0) sau read-write (1 - implicit)
  • 'CACHE_SET_TAGID(set)' - specifica tag-ID-ul unui anumit set. Valorile posibile sunt cuprinse intre 0 si 31. Implicit se defineste ca set mod 32.

17 martie 2011

Optimizarea codului de inmultire a 2 matrici

Un program simplu arata cam asa:

int main() {

// a, b, c fiind matricile : input (a,b) si output (c)

int k;
for (i=0; i<=n-1; i++)
for(j=0; j<=n-1; j++) {
for(k=0; k<=n-1; k++)
c[i][j] += a[i][k]*b[k][j];
}

return 0;
}

O prima optimizare este sa pastram suma partiala intr-un registru, pentru a evita timpul de si numarul de accese la c[i][j]:

int k;
for (i=0; i<=n-1; i++)
for(j=0; j<=n-1; j++) {
register double sum = 0.0;
for(k=0; k<=n-1; k++)
sum += a[i][k]*b[k][j];
c[i][j] = sum;
}

O alta optimizare ar fi modul de accesare a lui a[i][k], b[k][j] si c[i][j] prin intermediul unor pointeri si incrementarea acestora in functie de modul de deplasare in matrice:

int k;
double *pa, *pb;
for (i=0; i<=n-1; i++) {
pa = a[0]+i*n;
for(j=0; j<=n-1; j++) {
register double sum = 0.0;
pb = b[0];
for(k=0; k<=n-1; k++) {
pa++;
pb++;
sum += (*pa) * (*pb);
}
c[i][j] = sum;
}
}

In fine, s-a facut o mica comparatie pe criteriul timp intre diverse accesari: i,k,j (varianta buna), varianta medie (primul exemplu - i,j,k) si j,k,i (varianta proasta)

Nota... toate exemplele se testeaza pe matrici de dimensiuni mai mari de 1000, pentru a se vedea mai bine efectele.

12 martie 2011

Exemplu de bariera in Python

Exemplu de bariera - 10 thread-uri pornesc unul dupa altul si sunt afisate in ordinea intrarii lor, dupa care se face o bariera care asigura ca thread-urile vor astepta ca toate sa termine intrarea pentru a merge mai departe.
Mai departe, sunt eliberate unul cate unul si tinute intr-o alta bariera.


import threading
import time
import random

bariera = threading.Semaphore(value=0)
bariera2 = threading.Semaphore(value=0)
regcritica = threading.Semaphore(value=1)
threads = 10
n=threads
threadlist = []

# asigura ca toate thread-urile ies odata

def folosire(x):
print "[INTRARE]: ",x
barrier()
print "[IESIRE]: ",x
barrier()

def barrier():
global bariera,bariera2, regcritica,n,threads

# prima bariera este de intrare (aduna toate thread-urile)
regcritica.acquire();
n = n - 1;
if n==0:
for i in range(threads):
bariera.release();
regcritica.release();
bariera.acquire();
# a doua bariera este de iesire ( --//-- )
regcritica.acquire()
n = n + 1
if n == threads:
for i in range(threads):
bariera2.release()
regcritica.release()
bariera2.acquire()

random.seed()

for i in range(threads):
thread = threading.Thread(target=folosire, args=(i,)) # arg o functie si arg. ei
thread.start()
threadlist.append(thread)

for i in range(len(threadlist)):
threadlist[i].join()

09 martie 2011

Ierarhia de memorii


Urmatoarele exemple testeaza timpul efectuarii unei operatii pe un vector :

1) Consideram inmultirea unui vector de dimensiune foarte mare cu un scalar, in mai multi pasi. In pasul 1 accesam fiecare element din vector unul dupa altul si facem operatia, la pasul 2 accesam elementele din 2 in 2 cu revenire (intai consideram pozitiile impare apoi cele pare) si facem operatiile, si asa mai departe cu un pas de lungime maxima = lungimea vectorului, asa incat la final accesam doar prima pozitie din vector, reincarcam vectorul si accesam a doua pozitie.... pana la final.
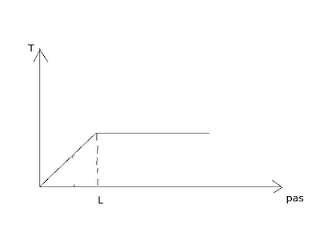
Ceea ce se observa este ca, teoretic, timpii calculatii corespunzatori fiecarui pas cresc treptat, pana ajung sa se stabilizeze. Timpii cresc cu atata cat ii ia incarcarii in memoria cache a vectorului.
In programul C, s-a folosit functia gettimeofday pentru aflarea orei exacte, pana la microsecunde (care este si ordinul de marime cu care se incarca datele specific cache-ului L2). Dupa fiecare pas, se face diferenta t2-t1 si se afiseaza aceasta valoare /cam la 10.000 pasi/ (pentru a nu se scrie pe ecran prea multe valori).


#include "stdio.h"
#include "sys/time.h"
#include "time.h"
#include "stdlib.h"

int main() {
int pas = 1, n = 100000, i, *v, scalar = 4;
v = (int *)malloc(n*sizeof(int));
for (i=0; i<=n-1; i++)
v[i] = i%10;
struct timeval tv;
time_t t1, t2;

do {
gettimeofday(&tv, NULL);
t1 = tv.tv_usec;
int j;
for(j=0; j<=pas-1; j++)
for(i=j; i<=n-1; i+=pas)
v[i] *= scalar;
gettimeofday(&tv, NULL);
t2 = tv.tv_usec;
if(pas%10000==1)
printf("pasul %d:\t t1=%d t2=%d\t t2-t1=%ld\n", pas, t1,t2, t2-t1);
pas++;
} while (pas<=n-1);

return 0;
}


2) Al doilea exemplu e asemanator, doar ca nu se mai folosesc pasii anteriori, ci se variaza dimensiunea vectorului a.i. sa ocupe intre 1M la inceput -> 12 M , cu un `pas` de 0.5M .
Ceea ce ar trebui sa se observe este scaderea performantei la modul urmator:

#include "stdio.h"
#include "sys/time.h"
#include "time.h"
#include "stdlib.h"

#define MAX 3145728 // 12MB
#define pas_dim 131072 // 0.5MB

// pt cache L2

int main() {
long int n = 32768, *v; // 2^20/32
int i, scalar = 4;
v = (long int *)malloc(MAX*sizeof(long int));
for (i=0; i<=MAX-1; i++)
v[i] = i%10;

struct timeval tv;
time_t t1, t2;

do {
gettimeofday(&tv, NULL);
t1 = tv.tv_usec;
for(i=0; i<=n-1; i++)
v[i] *= scalar;
gettimeofday(&tv, NULL);
t2 = tv.tv_usec;
n = n+pas_dim;

printf("dim %ld:\t t1=%d t2=%d\t (t2-t1)/n*1000=%lf\n", n, t1,t2, (t2-t1)/(double)n);

} while (n<=MAX-1);

return 0;
}

23 februarie 2011

Fire de executie in Python

Un exemplu de program in Python care afiseaza (oarecum aleator) id-urile unor thread-uri aflate in executie:

import time
from threading import Thread
from threading import Lock

class MyThread(Thread):

def __init__(self,n):
Thread.__init__(self)
self.tid=n

def run(self):
a = 0
for i in range(100000):
a += 1
print self.tid
def test():
nt = 10
for i in range(nt):
thr1=MyThread(i)
thr1.start()
thr1.join()

test()


Elementele de sincronizare in Python sunt:

* Lock - se poate afla intr-una din doua stari:

- blocat: daca se apeleaza release() se trece in starea neblocat

  • - neblocat (este creat neblocat): daca se apeleaza acquire() se trece in starea blocat

    Exemplu: Acelasi program de mai sus, insa cu id-urile threadurilor afisate ordonat (se foloseste Lock pentru ca in momentul afisarii zona sa fie exclusiv a firului de executie si sa nu poata interfera un alt thread)
import time
from threading import Thread
from threading import Lock

# afisare in ordine folosind lock
class MyThread(Thread):

def __init__(self,n):
Thread.__init__(self)
self.tid=n

def run(self):
a = 0
lock.acquire()
for i in range(100000):
a += 1
print self.tid
lock.release()
def test():
nt = 10
for i in range(nt):
thr1=MyThread(i)
thr1.start()
thr1.join()

lock = Lock()
test()


* Mecanisme de comunicatie - evenimente si conditii

Evenimente: un thread semnalizeaza un eveniment - notify(), iar altul asteapta ca evenimentul sa se intample - wait().

In Python, un obiect de tip event are un flag intern, initial setat pe false. Acesta poate fi setat pe true cu functia set() si resetat folosind clear(). Pentru a verifica starea flag-ului, se apeleaza functia isSet().

Un alt thread poate folosi metoda wait([timeout]) pentru a astepta ca un eveniment sa se intample (ca flag-ul sa devina true): daca in momentul apelarii wait(), flag-ul este true, thread-ul apelant nu se blocheaza, dar daca este false se blocheaza pana la setarea eventului. De altfel, la un set(), toate thread-urile care asteptau event-ul cu wait() vor fi notificate (si eligibile deci pentru a rula).

O variabila de tip conditie (Condition) este asociata cu un obiect mutex Lock. Acesta poate fi transmis ca parametru atunci cand mai multe variabile condition partajeaza un lock sau poate fi creat implicit.

Metodele prezente sunt acquire() si release() care le apeleaza pe cele corespunzatoare lock-ului si mai exista functiile wait(), notify() si notifyAll(), apelabile doar daca s-a reusit obtinerea lock-ului:

  • - metoda wait() elibereaza lock-ul si se blocheaza in asteptarea unei notificari
  • - metoda notify() deblocheaza un singur thread aflat in asteptare
  • - metoda notifyAll() deblocheaza toate thread-urile care asteptau indeplinirea conditiei

! Apelurile notify() si notifyAll() nu elibereaza lock-ul, deci un thread nu va fi trezit imediat ci doar cand apeluri de mai sus au terminat de folosit lock-ul si l-au eliberat.


* Semafoarele - sunt obiecte de sincronizare similare Lock-urilor insa difera de acestea prin faptul ca salveaza numarul de operatii de deblocare efectuate asupra lor. Un semafor gestioneaza un contor intern care este decrementat de un apel acquire() si incrementat de apelul release().

Contorul nu poate ajunge la valori negative deci atunci cand este apelata functia acquire() si contorul este 0 thredul se blocheaza pana cand alt thread apeleaza release(). Atunci cand este creat un semafor contorul are valoarea 1.

Exemplu: Problema producator-consumator, cand 3 producatori, 1 consumator si buffer nelimitat.


import time

import random

from threading import Thread

import threading

sem1 = threading.Semaphore(value=3) # 3 prod

# cons nu are semafor


class Prod(Thread):

def __init__(self,buf,n):

Thread.__init__(self)

self.idt = n

self.buf = buf


def run(self):

while True:

global sem1

sem1.acquire()

self.buf.append(1)

print "Prod",self.idt, " produce; Buffer=", self.buf

time.sleep(random.random()*5)

sem1.release()


class Cons(Thread):


def __init__(self,buf,idt):

Thread.__init__(self)

self.idt = idt

self.buf = buf


def run(self):

while True:

if len(self.buf) > 0:

del self.buf[0]

print "Cons",self.idt, " consuma; Buffer=", self.buf

time.sleep(random.random()*5)


def test():

buf = []

p1 = Prod(buf,0)

p2 = Prod(buf,1)

p3 = Prod(buf,2)

c = Cons(buf,0)

p1.start()

p2.start()

p3.start()

c.start()

test()

16 februarie 2011

Exemple simple in Python

Sortarea unei liste

lista = [10,34,11,8]

ok = 0
while ok==0:
ok =1
for i in range(0,len(lista)-1):
if(lista[i] > lista[i+1]):
aux = lista[i] # a,b = b,a
lista[i] = lista[i+1]
lista[i+1] = aux
ok = 0
print lista


Al n-lea element din sirul Fibonacci

n = 7
a = 1
b = 1
c = 0

for i in range(0,n-2):
c = a+b
a = b
b = c

if n==1 or n==2:
print 1
else:
print c


Definirea unei clase Multime, si a unor operatii: reuniune, intersectie, diferenta

class Multime:

def __init__ (self, lista):
self.n = 0
self.val = []
for i in range(0, len(lista)):
self.addEl(lista[i])

def contains (self, x):
for i in range(0,self.n):
if(self.val[i]==x):
return 1
return 0

def addEl (self, x):
if(self.contains(x)==0):
self.n += 1
self.val.append(x)

def reunion (self,l2):
nou = Multime(self.val)
for i in range(0,l2.n):
nou.addEl(l2.val[i])
return nou.val

def intersection(self,l2):
nou = Multime([])
for i in range(0, l2.n):
if(self.contains(l2.val[i])==1):
nou.addEl(l2.val[i])
return nou.val

def diferenta(self, l2):
nou = Multime([])
for i in range(0, self.n):
if(l2.contains(self.val[i])==0):
nou.addEl(self.val[i])
return nou.val

m1 = Multime([1,2,3])
m2 = Multime([3,4,5,6])

print "m1 U m2 = ",m1.reunion(m2)
print "m1 ^ m2 = ",m1.intersection(m2)
print "m1 \ m2 = ",m1.diferenta(m2)